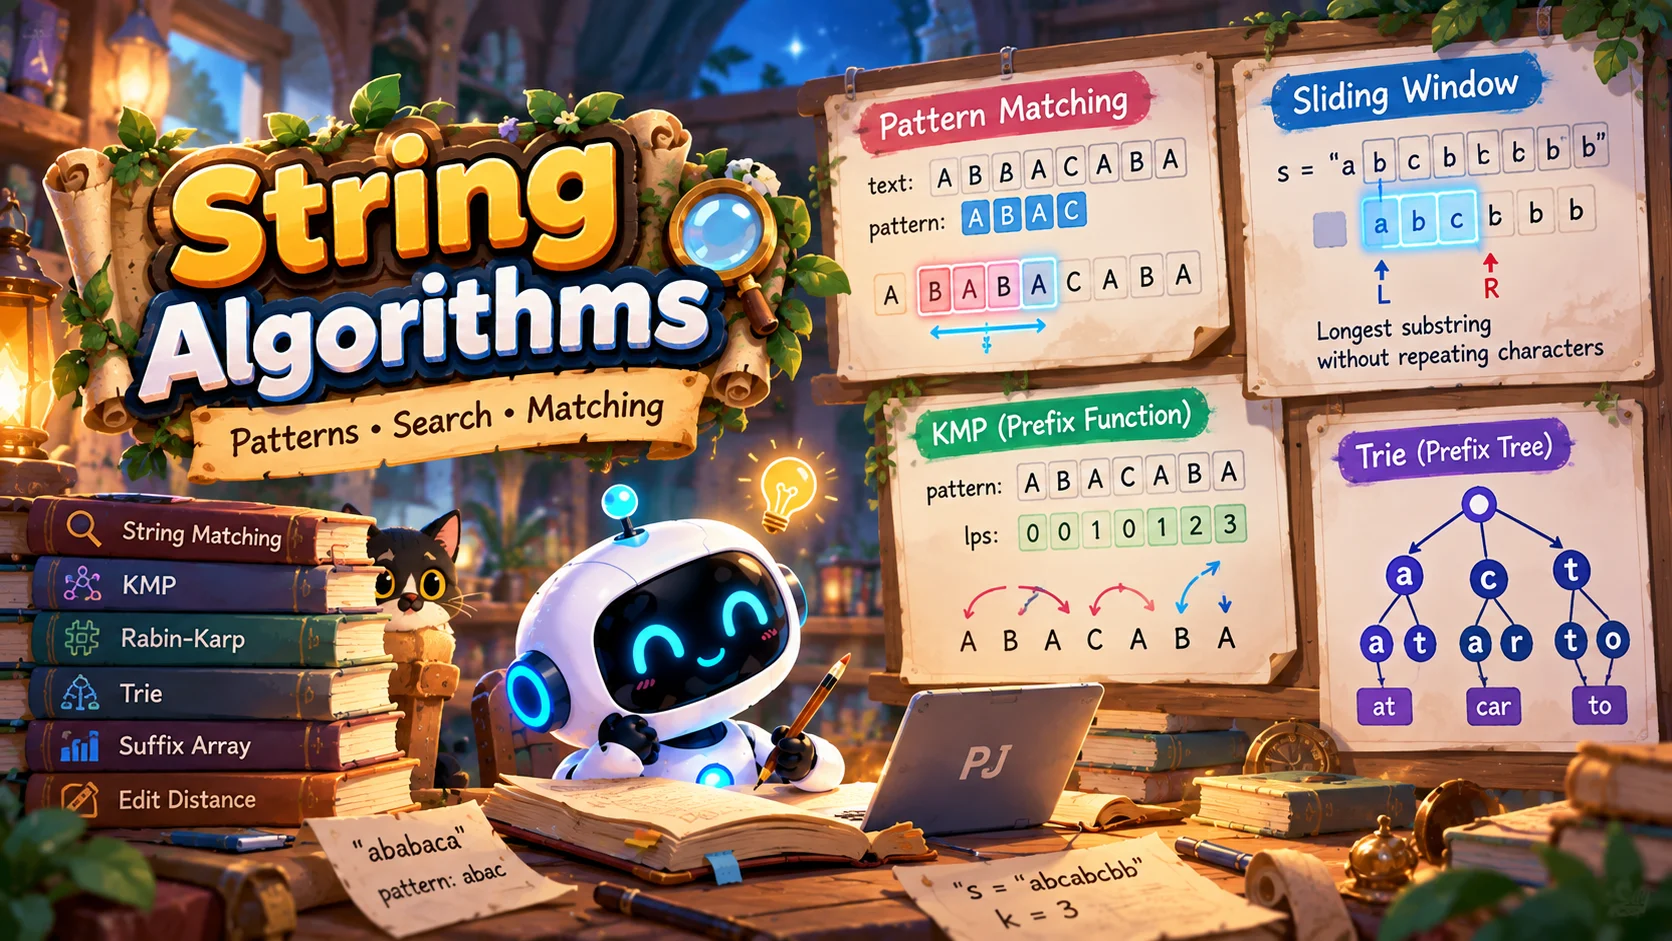
"Thuật toán chuỗi nhanh đều chia sẻ một bí mật: đừng so sánh lại những ký tự bạn đã biết. Naive matching quên sạch sau mỗi lần thất bại nên chậm; KMP nhớ bằng 'hàm thất bại', Z nhớ bằng 'z-box', hashing nhớ bằng 'tiền tố'. Cả nghệ thuật là ghi nhớ để không quét lại."
Đây là quyển thứ chín. Xử lý chuỗi có những thuật toán đẹp nhất — và cũng dễ cài sai nhất — trong toàn bộ CS. Sợi chỉ đỏ xuyên suốt vẫn là: đừng làm lại việc đã làm. Quyển này dạy bốn nhóm vũ khí: so khớp mẫu (KMP, Z, Rabin-Karp), băm chuỗi (hashing), cây tiền tố (Trie), và đối xứng (Manacher).
Tư tưởng chung
Phần 0 — Đừng so sánh lại cái đã biết
Mọi thuật toán chuỗi nhanh đều khai thác thông tin đã học để khỏi quét lại.
Các bài toán chuỗi cốt lõi xoay quanh so khớp (tìm mẫu trong văn bản), so sánh (hai đoạn có giống nhau không), và cấu trúc (tiền tố, hậu tố, đối xứng).
Điểm chung của mọi thuật toán chuỗi nhanh: chúng khai thác thông tin đã học được để tránh so sánh lại. Naive matching là kẻ ngốc — mỗi lần thất bại lại quên sạch và bắt đầu lại. Các thuật toán thông minh thì nhớ:
| Thuật toán | "Nhớ" bằng | Để tránh |
|---|---|---|
| KMP | Hàm tiền tố (failure function) | Quét lại phần văn bản đã khớp |
| Z-function | Z-box (đoạn đã khớp gần nhất) | Tính lại các khớp đã biết |
| Rabin-Karp | Rolling hash (băm tăng dần) | Tính lại băm cả cửa sổ |
| Hashing | Băm tiền tố (prefix hash) | So sánh ký tự từng cái |
Đây chính là sợi chỉ đỏ của cả bộ sách — đừng làm lại việc đã làm. Two pointers không lùi con trỏ; DP không tính lại bài con; và thuật toán chuỗi không so sánh lại ký tự đã biết. Cùng một triết lý, áp lên chuỗi.
Điểm xuất phát
Phần 1 — Naive matching & vì sao nó chậm
Thử khớp mẫu tại mọi vị trí — đơn giản nhưng lãng phí.
Cách ngây thơ: thử khớp mẫu tại mọi vị trí của văn bản.
def naive_search(text, pattern):
    n, m = len(text), len(pattern)
    result = []
    for i in range(n - m + 1):          # thử mọi vị trí bắt đầu
        if text[i:i+m] == pattern:      # so sánh cả mẫu
            result.append(i)
    return result
Vấn đề: trường hợp xấu O(n·m). Ví dụ text = "aaaa...a", pattern = "aaa...ab" — mỗi vị trí khớp gần hết rồi mới thất bại ở ký tự cuối, rồi quên sạch và lặp lại. Tất cả các thuật toán bên dưới ra đời để khắc phục đúng sự lãng phí này.
Phần A · So khớp mẫu (Pattern Matching)
Pattern matching
A.1 — KMP: hàm tiền tố (failure function)
O(n+m) nhờ "hàm tiền tố" — biết khi thất bại thì nhảy lùi về đâu.
KMP (Knuth-Morris-Pratt) đạt O(n+m) nhờ hàm tiền tố — thứ cho biết khi thất bại thì "nhảy lùi" về đâu mà không cần quét lại văn bản.
Hàm tiền tố là gì?
π[i] = độ dài của tiền tố thực dài nhất của pattern[0..i] mà đồng thời là hậu tố của nó. Nói cách khác: "phần đầu trùng phần cuối dài nhất".
Ví dụ với "ababaca":
   pattern:  a  b  a  b  a  c  a
   π:        0  0  1  2  3  0  1
                        ↑
   π[4]=3 vì "aba" (tiền tố) = "aba" (hậu tố của "ababa")
Tính hàm tiền tố
def prefix_function(s):
    n = len(s)
    pi = [0] * n
    for i in range(1, n):
        j = pi[i-1]                     # thử nối tiếp khớp trước đó
        while j > 0 and s[i] != s[j]:
            j = pi[j-1]                 # ⭐ không khớp → nhảy lùi theo π
        if s[i] == s[j]:
            j += 1
        pi[i] = j
    return pi
Tìm mẫu bằng KMP
def kmp_search(text, pattern):
    if not pattern:
        return []
    pi = prefix_function(pattern)
    result, j = [], 0
    for i in range(len(text)):
        while j > 0 and text[i] != pattern[j]:
            j = pi[j-1]                 # ⭐ không khớp → nhảy lùi, KHÔNG lùi i
        if text[i] == pattern[j]:
            j += 1
        if j == len(pattern):           # khớp đủ mẫu
            result.append(i - j + 1)
            j = pi[j-1]                 # tiếp tục tìm chỗ tiếp theo
return resultKhi khớp thất bại ở vị trí j, thay vì lùi con trỏ văn bản i, ta giữ nguyên i và chỉ nhảy j lùi về π[j-1] — vì ta đã BIẾT phần pattern[0..π[j-1]-1] chắc chắn khớp (vừa là tiền tố vừa là hậu tố). Con trỏ văn bản chỉ tiến, không bao giờ lùi → O(n).
Hàm tiền tố được xây từng bước từ kết quả trước (π[i] dùng π[i-1], π[j-1]) — chính là tư duy quy hoạch động. Và giống Two Pointers, con trỏ văn bản "chỉ tiến không lùi" cho ta O(n) nhờ phân tích khấu hao.
Pattern matching
A.2 — Z-function
Người anh em của KMP, đôi khi trực quan hơn.
Z-function là người anh em của KMP. z[i] = độ dài đoạn dài nhất bắt đầu tại i mà trùng với tiền tố của chuỗi.
   s:     a  a  b  c  a  a  b  x  a  a  a  z
   z:     -  1  0  0  3  1  0  0  2  2  1  0
                       ↑
   z[4]=3 vì "aab" (bắt đầu tại 4) = "aab" (tiền tố)
def z_function(s):
n = len(s)
z = [0] * n # z[0] để 0 (quy ước, thường không dùng)
l, r = 0, 0 # [l, r] = "z-box": đoạn khớp tiền tố xa nhất bên phải
for i in range(1, n):
if i < r:
z[i] = min(r - i, z[i - l]) # ⭐ tận dụng thông tin trong z-box (gương)
while i + z[i] < n and s[z[i]] == s[i + z[i]]:
z[i] += 1 # mở rộng thủ công phần chưa biết
if i + z[i] > r:
l, r = i, i + z[i] # cập nhật z-box
return zTìm mẫu bằng Z-function
Ghép pattern + phân_cách + text, rồi tìm vị trí có z[i] == len(pattern):
def z_search(text, pattern):
    combined = pattern + "\x00" + text   # ký tự phân cách không có trong input
    z = z_function(combined)
    m = len(pattern)
    result = []
    for i in range(m + 1, len(combined)):
        if z[i] == m:                    # đoạn tại i khớp trọn mẫu
            result.append(i - m - 1)     # đổi về vị trí trong text
    return result
Z-box hoạt động như hàng đợi trong sliding window: nó nhớ "đoạn khớp tiền tố xa nhất về bên phải mà ta đã thấy", để những vị trí i nằm trong đó có thể sao chép kết quả gương thay vì tính lại. Lại là "đừng làm lại việc đã làm".
Pattern matching
A.3 — Rabin-Karp (rolling hash)
Biến so khớp chuỗi thành so khớp số, trung bình O(n+m).
Rabin-Karp biến so khớp chuỗi thành so khớp số: băm mẫu, rồi trượt một "cửa sổ băm" qua văn bản, cập nhật băm tăng dần (rolling). Trung bình O(n+m).
def rabin_karp(text, pattern):
    n, m = len(text), len(pattern)
    if m > n: return []
    BASE, MOD = 256, 10**9 + 7
    p_hash = t_hash = 0
    power = 1                            # BASE^(m-1) % MOD
    for i in range(m):
        p_hash = (p_hash * BASE + ord(pattern[i])) % MOD
        t_hash = (t_hash * BASE + ord(text[i])) % MOD
        if i < m - 1:
            power = (power * BASE) % MOD
    result = []
    for i in range(n - m + 1):
        if p_hash == t_hash:            # ⭐ băm khớp → kiểm tra THẬT (tránh va chạm)
            if text[i:i+m] == pattern:
                result.append(i)
        if i < n - m:                   # trượt cửa sổ: bỏ ký tự đầu, thêm ký tự cuối
            t_hash = ((t_hash - ord(text[i]) * power) * BASE + ord(text[i+m])) % MOD
            t_hash %= MOD               # ⭐ đảm bảo không âm
return resultBăm khớp KHÔNG chắc chuỗi khớp — có thể va chạm (hai chuỗi khác nhau cùng băm). Vì vậy khi băm khớp, phải kiểm tra lại chuỗi thật. Bỏ bước này là bug tiềm ẩn nguy hiểm. (Trong thi đấu, đôi khi bỏ qua kiểm tra và chấp nhận rủi ro cực nhỏ với double hashing — Phần B.2.)
Rolling hash chính là cửa sổ trượt cố định áp lên băm — "thêm ký tự vào, bỏ ký tự ra" thay vì tính lại cả cửa sổ. Cùng ý tưởng cập nhật phần thay đổi ở Bí kíp Two Pointers.
Pattern matching
A.4 — KMP vs Z vs Rabin-Karp
Chọn công cụ nào cho bài so khớp?
| Tiêu chí | KMP | Z-function | Rabin-Karp |
|---|---|---|---|
| Độ phức tạp | O(n+m) chắc chắn |
O(n+m) chắc chắn |
O(n+m) trung bình |
| Trường hợp xấu | O(n+m) |
O(n+m) |
O(n·m) (va chạm liên tục) |
| Cần kiểm tra lại? | Không | Không | Có (chống va chạm) |
| Điểm mạnh | Chuẩn, ổn định | Trực quan, đa dụng | Dễ mở rộng đa mẫu, so đoạn |
| Dễ cài đúng | Trung bình (dễ lệch π) | Trung bình (dễ lỗi z-box) | Dễ (cẩn thận tràn/âm) |
Chọn nhanh: cần một thuật toán so khớp ổn định, chắc chắn → KMP hoặc Z (chọn cái bạn thuộc hơn). Cần so sánh nhiều đoạn con hoặc mở rộng linh hoạt → hashing (Phần B).
Phần B · Băm chuỗi (String Hashing)
String hashing
B.1 — Polynomial hashing & so sánh đoạn con O(1)
Sau tiền xử lý O(n), so sánh bất kỳ hai đoạn con trong O(1).
Ý tưởng: coi chuỗi như một số trong hệ cơ số lớn. Băm đa thức: hash(s) = s[0]·B^(k-1) + s[1]·B^(k-2) + ... + s[k-1] (mod một số nguyên tố lớn). Sau tiền xử lý O(n), so sánh bất kỳ hai đoạn con trong O(1).
class StringHash:
    def __init__(self, s):
        self.BASE, self.MOD = 131, 10**9 + 7
        n = len(s)
        self.prefix = [0] * (n + 1)     # prefix[i] = băm của s[0..i-1]
        self.power = [1] * (n + 1)      # power[i] = BASE^i
        for i in range(n):
            self.prefix[i+1] = (self.prefix[i] * self.BASE + ord(s[i])) % self.MOD
            self.power[i+1]  = (self.power[i] * self.BASE) % self.MOD

    def get_hash(self, l, r):           # băm của s[l..r] (gồm hai đầu) — O(1)
return (self.prefix[r+1] - self.prefix[l] * self.power[r-l+1]) % self.MODĐây chính là "tổng tiền tố" áp lên băm. Giống prefix sum cho tổng đoạn (sum[l..r] = prefix[r+1] - prefix[l]), băm đoạn con là prefix[r+1] - prefix[l]·BASE^len. Cùng một kỹ thuật tiền tố (Bí kíp DP & Two Pointers), chỉ khác phép toán — nhờ nó, kiểm tra "hai đoạn con có giống nhau không" chỉ tốn O(1).
Ứng dụng mạnh: so sánh đoạn con O(1) mở khóa nhiều bài — như kết hợp binary search để tìm "tiền tố chung dài nhất" hay "palindrome dài nhất" trong O(n log n) (nối với Bí kíp Binary Search: nhị phân trên độ dài + kiểm tra bằng hash).
String hashing
B.2 — Bẫy va chạm & double hashing
Hai chuỗi khác nhau có thể cùng giá trị băm — phòng thế nào?
Va chạm (collision): hai chuỗi khác nhau có thể cùng giá trị băm. Với một MOD ~10⁹, xác suất va chạm ngẫu nhiên nhỏ nhưng không phải không, và trong thi đấu có thể bị "anti-hash test" cố tình phá.
Cách phòng:
- Kiểm tra lại chuỗi thật khi băm khớp (an toàn tuyệt đối, nhưng mất
O(m)mỗi lần khớp). - Double hashing: dùng hai cặp (BASE, MOD) độc lập; chỉ coi là khớp khi cả hai băm trùng. Xác suất va chạm giảm còn
~1/MOD², thường đủ an toàn để bỏ kiểm tra lại. - Chọn MOD nguyên tố lớn và BASE ngẫu nhiên (chống test cố tình).
Đừng dùng số nhỏ hoặc lũy thừa 2 làm MOD — dễ bị đụng độ hệ thống. Luôn dùng số nguyên tố lớn (10⁹+7, 10⁹+9). Trong C++/Java, cẩn thận tràn số khi nhân — dùng kiểu 64-bit và mod sau mỗi phép nhân.
Phần C · Trie (Cây tiền tố)
Prefix tree
C.1 — Trie: cấu trúc & thao tác
Lưu tập chuỗi bằng cách chia sẻ tiền tố chung.
Trie (cây tiền tố) lưu một tập chuỗi bằng cách chia sẻ tiền tố chung — mỗi cạnh là một ký tự, mỗi đường đi từ gốc là một tiền tố. Tối ưu cho truy vấn tiền tố và nhiều mẫu.
   Trie chứa {"cat", "car", "card", "dog"}:

            (root)
           /      \
          c        d
          |        |
          a        o
         / \       |
        t   r      g*
        *   |
            d*     (* = kết thúc một từ)
class TrieNode:
def __init__(self):
self.children = {} # ký tự → TrieNode
self.is_end = False # có từ nào kết thúc tại đây không
class Trie:
def __init__(self):
self.root = TrieNode()
def insert(self, word):
node = self.root
for ch in word:
if ch not in node.children:
node.children[ch] = TrieNode()
node = node.children[ch]
node.is_end = True
def search(self, word): # có từ này CHÍNH XÁC không?
node = self._find(word)
return node is not None and node.is_end
def starts_with(self, prefix): # có từ nào bắt đầu bằng prefix không?
return self._find(prefix) is not None
def _find(self, s):
node = self.root
for ch in s:
if ch not in node.children:
return None
node = node.children[ch]
return nodeĐộ phức tạp: chèn/tìm một từ độ dài L là O(L) — không phụ thuộc số từ đã lưu. Đó là lợi thế lớn khi có nhiều từ.
Prefix tree
C.2 — Ứng dụng & Aho-Corasick
Autocomplete, nhiều mẫu, XOR cực đại, và "KMP trên cây".
Trie tỏa sáng khi:
- Tự động hoàn thành (autocomplete): gõ tiền tố → duyệt cây con để gợi ý.
- Nhiều mẫu chia sẻ tiền tố: kiểm tra hàng loạt từ hiệu quả.
- Word Search II (đã gặp ở Bí kíp Backtracking): nhồi tất cả từ vào Trie rồi DFS lưới một lần, cắt tỉa theo Trie — nhanh hơn nhiều so với tìm từng từ.
- XOR cực đại (Trie nhị phân): lưu các số dưới dạng bit trong Trie; tìm cặp XOR lớn nhất bằng cách "đi ngược bit" tham lam.
🔸 Aho-Corasick (nâng cao — biết để không sợ)
Muốn tìm nhiều mẫu cùng lúc trong một văn bản trong O(n + Σ|mẫu| + số_khớp)? Aho-Corasick = KMP áp lên Trie. Nó xây Trie các mẫu, rồi thêm liên kết thất bại (failure link) giữa các nút — hệt hàm tiền tố của KMP nhưng trên cây. Khi quét văn bản, gặp không khớp thì nhảy theo failure link. Đây là công cụ chủ lực cho lọc từ khóa, phát hiện nhiều pattern (như bộ lọc nội dung).
Aho-Corasick là sự hợp nhất của hai vũ khí trong quyển này: Trie (cấu trúc) + failure function của KMP (nhảy lùi khi thất bại). Hiểu cả hai là hiểu Aho-Corasick.
Phần D · Đối xứng (Palindrome)
Palindrome
D.1 — Manacher: palindrome dài nhất O(n)
Nhanh hơn DP O(n²) nhờ chèn phân cách + đối xứng gương.
Tìm chuỗi con đối xứng (palindrome) dài nhất trong O(n) — nhanh hơn DP O(n²). Mẹo kép: (1) chèn ký tự phân cách để xử lý palindrome chẵn và lẻ đồng nhất; (2) dùng đối xứng gương để tái sử dụng kết quả đã tính.
def manacher(s):
    if not s: return ""
    # biến đổi "abc" → "^#a#b#c#$": # xử lý chẵn/lẻ, ^ và $ chặn biên
    t = "^#" + "#".join(s) + "#$"
    n = len(t)
    p = [0] * n                         # p[i] = bán kính palindrome tại tâm i
    center = right = 0
    for i in range(1, n - 1):
        if i < right:
            p[i] = min(right - i, p[2 * center - i])   # ⭐ soi gương qua center
        while t[i + p[i] + 1] == t[i - p[i] - 1]:       # mở rộng phần chưa biết
            p[i] += 1
        if i + p[i] > right:            # cập nhật palindrome xa nhất bên phải
            center, right = i, i + p[i]
    max_len, center_index = max((p[i], i) for i in range(n))
    start = (center_index - max_len) // 2
return s[start:start + max_len]Biến right (biên palindrome xa nhất) đóng vai như z-box của Z-function, như cửa sổ của sliding window — nó nhớ "vùng đã khớp" để các tâm i bên trong soi gương lấy kết quả thay vì tính lại. Đây là lần thứ ba trong quyển này ta thấy đúng thủ thuật đó.
Không nhớ nổi Manacher? Có thể tìm palindrome dài nhất bằng hashing + binary search (O(n log n)) — nhị phân trên bán kính, kiểm tra đối xứng bằng so sánh hash của đoạn với đoạn đảo. Chậm hơn chút nhưng dễ nhớ, và là ứng dụng đẹp của Phần B + Bí kíp Binary Search.
Phần chung
Cạm bẫy
E — ☠️ Cạm bẫy chết người
Bảy lỗi khiến string algorithms từ đúng thành sai (hoặc TLE).
💀 Bẫy #1 — Dùng naive khi n·m quá lớn. Thấy chuỗi dài + nhiều truy vấn mà vẫn text[i:i+m] == pattern trong vòng lặp → TLE. Chuyển sang KMP/Z/hashing.
💀 Bẫy #2 — Va chạm hash không kiểm tra. Băm khớp không đảm bảo chuỗi khớp. Hoặc kiểm tra lại chuỗi thật, hoặc dùng double hashing.
💀 Bẫy #3 — Tràn số / số âm trong hashing. Trong C++/Java, nhân băm dễ tràn 64-bit → mod sau mỗi phép nhân. Trong rolling hash, sau phép trừ phải +MOD rồi %MOD để tránh giá trị âm.
💀 Bẫy #4 — Lệch chỉ số trong hàm tiền tố / Z-box. π và z cực dễ lệch một đơn vị hoặc quản lý sai biên [l, r]. Học thuộc một bản cài đúng và kiểm chứng bằng ví dụ nhỏ.
💀 Bẫy #5 — MOD yếu hoặc BASE tồi. MOD nhỏ / lũy thừa 2 → va chạm hệ thống. Dùng số nguyên tố lớn + BASE ngẫu nhiên.
💀 Bẫy #6 — Trie tốn bộ nhớ. Mỗi nút mảng 26 con lãng phí nếu chuỗi thưa; dùng dict cho tập ký tự lớn/thưa. Bảng chữ cái nhỏ cố định thì mảng nhanh hơn.
💀 Bẫy #7 — Manacher: sai biến đổi / quên ký tự chặn. Quên ^ và $ → phải kiểm tra biên thủ công, dễ lỗi. Sai công thức start = (center - len)//2 → lấy nhầm đoạn.
Kết nối
F — 🔗 Nối với bộ sách
String algorithms là "đừng làm lại việc" mặc áo mới.
- "Đừng làm lại việc" — sợi chỉ đỏ chung. KMP/Z/hashing nhớ để không quét lại; hệt như two pointers không lùi con trỏ, DP không tính lại bài con.
- Rolling hash = cửa sổ trượt. Cập nhật băm "thêm vào, bỏ ra" chính là sliding window cố định (Two Pointers).
- Prefix hash = prefix sum. Băm đoạn con
O(1)là kỹ thuật tổng tiền tố (DP, Two Pointers), chỉ đổi phép toán. - Hashing + binary search. Tìm palindrome / tiền tố chung dài nhất bằng nhị phân trên độ dài + kiểm tra hash (Binary Search).
- Trie + Backtracking + Bit. Word Search II dùng Trie để cắt tỉa DFS lưới; Trie nhị phân giải bài XOR. Aho-Corasick = Trie + failure function của KMP.
- Failure function ~ DP.
πvàzđược xây từng bước từ kết quả trước — tư duy quy hoạch động.
Tra cứu
G — 📋 Bảng tra cứu thần tốc
Bài toán → vũ khí → độ phức tạp.
| Bài toán | Vũ khí | Độ phức tạp |
|---|---|---|
| Tìm một mẫu (ổn định) | KMP hoặc Z-function | O(n+m) |
| Tìm một mẫu (linh hoạt) | Rabin-Karp | O(n+m) TB |
| So sánh nhiều đoạn con | Polynomial hashing | O(n) xử lý, O(1)/truy vấn |
| Truy vấn tiền tố / autocomplete | Trie | O(L)/thao tác |
| Nhiều mẫu cùng lúc | Aho-Corasick | O(n + Σm + khớp) |
| Palindrome dài nhất | Manacher | O(n) |
| XOR cặp lớn nhất | Trie nhị phân | O(n·bits) |
Bốn câu hỏi khi gặp bài chuỗi: (1) Một mẫu hay nhiều mẫu? (2) Cần so khớp, so sánh đoạn, hay truy vấn tiền tố? (3) Có liên quan đối xứng (palindrome) không? (4) Chuỗi lớn cỡ nào (naive có kịp không)?
Luyện tập
H — 🎯 Lộ trình luyện tập theo cấp độ
Từ nhập môn đến trùm cuối, tên bài theo phong cách LeetCode.
🟢 Cấp 1 — Nhập môn: Implement strStr() (KMP/Z), Implement Trie (Prefix Tree), Longest Common Prefix, Valid Anagram / Group Anagrams.
🟡 Cấp 2 — Vận dụng: Repeated Substring Pattern (hàm tiền tố KMP), Shortest Palindrome (KMP trên s + '#' + reverse(s)), Longest Palindromic Substring (Manacher), Design Add and Search Words (Trie + .), Find All Anagrams in a String (sliding window).
🔴 Cấp 3 — Nâng cao: Maximum XOR of Two Numbers (Trie nhị phân), Longest Duplicate Substring (hashing + binary search), Word Search II (Trie + DFS lưới), Distinct Echo Substrings (hash so đoạn), Palindrome Pairs (Trie/hashing).
⚫ Cấp trùm cuối: Stream of Characters (Aho-Corasick), Number of Matching Subsequences, Suffix Array / Suffix Automaton (tự nghiên cứu). Và chứng minh bằng tay: vì sao hàm tiền tố cho phép KMP chạy O(n).
Với mỗi bài, trước khi code hãy trả lời bốn câu hỏi ở Phần G. Nhiều bài chuỗi có nhiều lời giải (KMP / Z / hashing / Trie đều giải được) — hãy chọn công cụ bạn cài đúng chắc nhất dưới áp lực. Và luôn nhớ sợi chỉ đỏ: ta đang tránh so sánh lại cái gì?
Lời kết
🎓 Tâm pháp String Algorithms
Năm câu gói trọn nghệ thuật xử lý chuỗi.
- Mọi thuật toán chuỗi nhanh đều "nhớ để không quét lại". KMP nhớ bằng hàm tiền tố, Z bằng z-box, hashing bằng prefix.
- KMP: thất bại thì nhảy
jlùi, giữ nguyên con trỏ văn bản. Con trỏ chỉ tiến →O(n). - Hashing biến so sánh chuỗi thành so sánh số — nhưng cẩn thận va chạm. Prefix hash cho so sánh đoạn con
O(1); luôn kiểm tra lại hoặc double hash. - Trie cho nhiều mẫu & truy vấn tiền tố. Một mẫu → KMP; nhiều mẫu chia sẻ tiền tố → Trie; nhiều mẫu trên luồng → Aho-Corasick.
- Palindrome dài nhất → Manacher
O(n)(hoặc hashing + binary search nếu quên).
Luyện đủ bốn cấp ở Phần H, mỗi bài đều tự hỏi bốn câu định hình và chọn công cụ mình cài chắc nhất — sau khoảng 30–40 bài, bạn sẽ nhìn ra ngay bài nào là so khớp, bài nào là so sánh đoạn, bài nào cần Trie. Đó là lúc bạn đã làm chủ nghệ thuật xử lý chuỗi. 📜
Chín quyển, một tư tưởng: khai thác cấu trúc và ghi nhớ để không bao giờ tính lại điều đã biết. Quyển String khép lại một vòng đẹp — sợi chỉ đỏ "đừng làm lại việc đã làm" đúng cho tối ưu (DP), cho quét mảng (two pointers), và cho cả xử lý ký tự (KMP, Z, hashing). Chúc bạn luyện công viên mãn, cửu nghệ toàn thông! 🥋📜
Bình luận 0
Chưa có bình luận nào. Hãy là người đầu tiên!